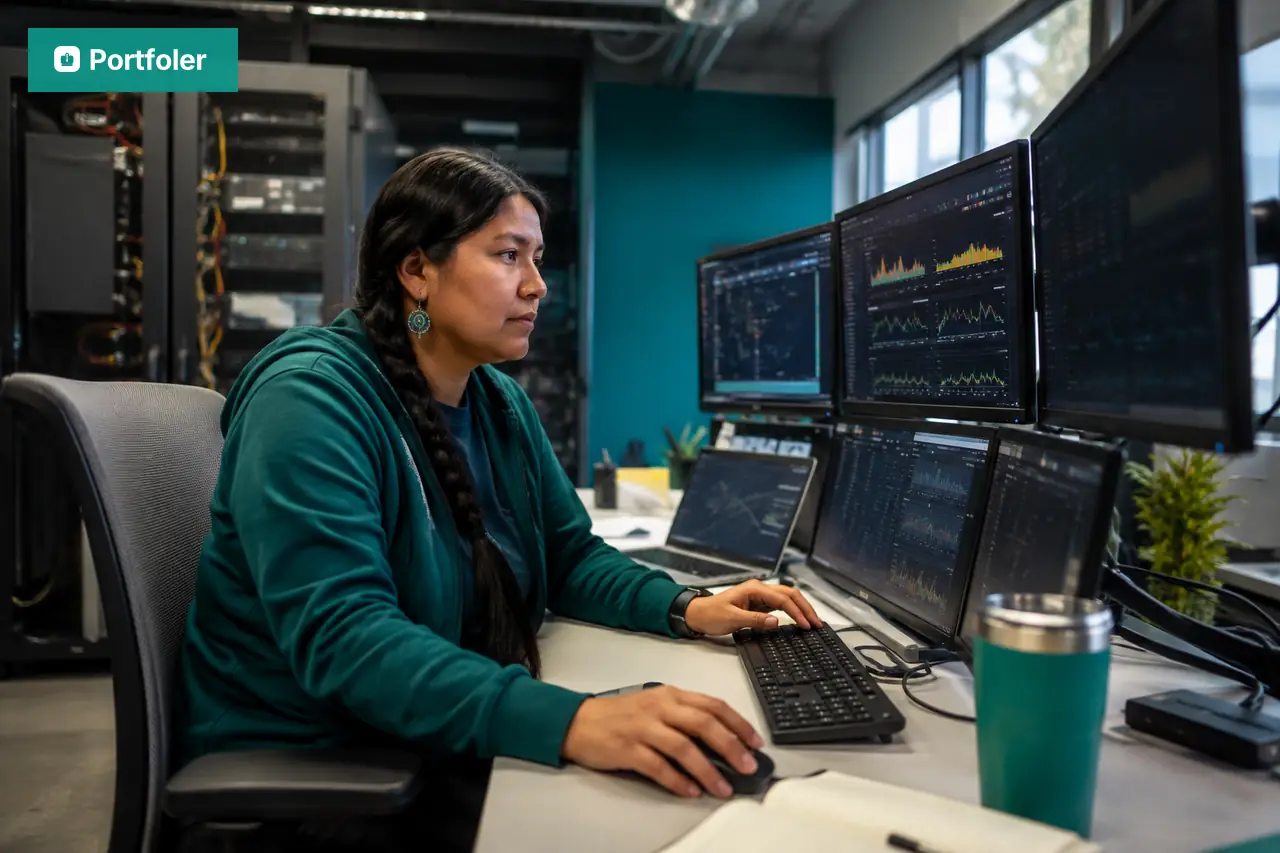
Le Site Reliability Engineer (SRE) est le garant de la disponibilité et de la performance des services en production. À la croisée du développement et de l'exploitation, il applique une démarche d'ingénierie aux problèmes d'infrastructure pour que les applications restent fiables, même à grande échelle.
Description du métier
Né chez Google, le rôle de SRE consiste à traiter la fiabilité comme une fonctionnalité produit à part entière. Le SRE définit des objectifs de niveau de service (SLO), mesure les indicateurs (SLI) et pilote un budget d'erreur qui arbitre entre vélocité des livraisons et stabilité du système.
Concrètement, il automatise ce qui peut l'être, supprime le travail répétitif (le « toil »), conçoit des architectures résilientes et intervient lors des incidents critiques. Son objectif : rendre les pannes rares, courtes et sans surprise.
Missions principales
- Définir et suivre les SLO/SLI et gérer le budget d'erreur des services.
- Automatiser le déploiement, la montée en charge et la reprise après incident.
- Mettre en place l'observabilité : métriques, logs, traces et alerting.
- Piloter la gestion des incidents et rédiger les post-mortems sans blâme.
- Concevoir des architectures haute disponibilité et tester la résilience (chaos engineering).
- Réduire le toil par des outils et des scripts d'automatisation.
Compétences requises
Hard skills : Linux, conteneurs et Kubernetes, infrastructure as code (Terraform), un cloud public (AWS, GCP ou Azure), scripting (Python, Go, Bash), CI/CD, observabilité (Prometheus, Grafana), réseau et sécurité.
Soft skills : sang-froid en situation d'incident, rigueur, sens du service, communication claire, esprit d'amélioration continue.
Salaires dans le monde
La rémunération d'un SRE figure parmi les plus élevées de la tech, en raison de la rareté du profil et de la criticité des enjeux. Le tableau des salaires par pays ci-dessous donne des fourchettes brutes annuelles indicatives, en monnaie locale, pour un profil confirmé.
Parcours de carrière
- Junior (0 – 3 ans) : administration système, support d'infrastructure, premières automatisations.
- Mid (3 – 6 ans) : ownership d'un périmètre de production, mise en place d'observabilité et de CI/CD.
- Senior (6 – 10 ans) : architecture de fiabilité, pilotage d'incidents majeurs, définition des SLO.
- Expert / Lead (10+ ans) : SRE Lead, Principal Engineer, Head of Reliability / Platform.
Formation & études
- Bac+3 à Bac+5 en informatique, réseaux ou systèmes (écoles d'ingénieurs, universités).
- Voie DevOps / administration système avec montée en compétences cloud et automatisation.
- Certifications valorisées : CKA/CKAD (Kubernetes), AWS/GCP, Terraform Associate.
Débouchés et secteurs
Le SRE est recherché par les entreprises à fort trafic : SaaS, fintech, e-commerce, jeux vidéo, plateformes cloud, télécoms. La transformation vers le cloud et l'essor des architectures distribuées entretiennent une forte demande.
En résumé
Un métier stratégique, exigeant et très bien rémunéré, au cœur de la fiabilité des services numériques. Si vous savez concilier ingénierie logicielle et exploitation à grande échelle, créez votre profil sur Portfoler.com et connectez-vous aux entreprises qui recrutent des profils SRE.
 États-Unis
 Royaume-Uni
 Allemagne
 France
 Canada
 Émirats arabes unis
 Maroc
 Inde
 Espagne
 Australie